
지난 편에서는 AX를 여섯 단계의 순환으로 놓고 보았습니다. 그중 ② 현재 진단이 ③ 경로 설계의 입력값이자 ⑥ 성과 검증의 기준선이라는 것, 그래서 역량검사가 순환 안에서 두 번 일한다는 이야기였습니다.
📚 AX, 어디부터 시작할 것인가 (전 6부)
1부. AI를 도입했는데, 왜 일하는 방식은 그대로일까 — 왜 AX인가
2부. AX에는 프레임워크가 필요하다 — AX CANVAS 6단계▶ 3부. 역량검사 ① 'AI 좀 씁니다'로는 알 수 없는 것
4부. 역량검사 ② 같은 70점도 서로 다른 70점이다
5부. "그래서 효과가 있었습니까"에 답하는 법
6부. AX는 한 번으로 끝나지 않는다
이번 3부에서 다룰 것은 '무엇을 검사하는가'입니다. 모든 진단이 ② 현재 진단의 자리를 채울 수 있는 것은 아닙니다. 경로 설계에 쓸 수 있는 진단이 되려면 무엇을 어떻게 검사해야 하는지 이야기합니다.
"저희 직원들은 챗GPT 정도는 다 씁니다"
교육 담당자와 이야기를 나누다 보면 자주 듣는 말입니다. 그리고 이 말은 대개 사실입니다. 계정도 있고, 써본 적도 있습니다.
그런데 '쓴다'는 한 단어 안에는 전혀 다른 상태들이 섞여 있습니다.
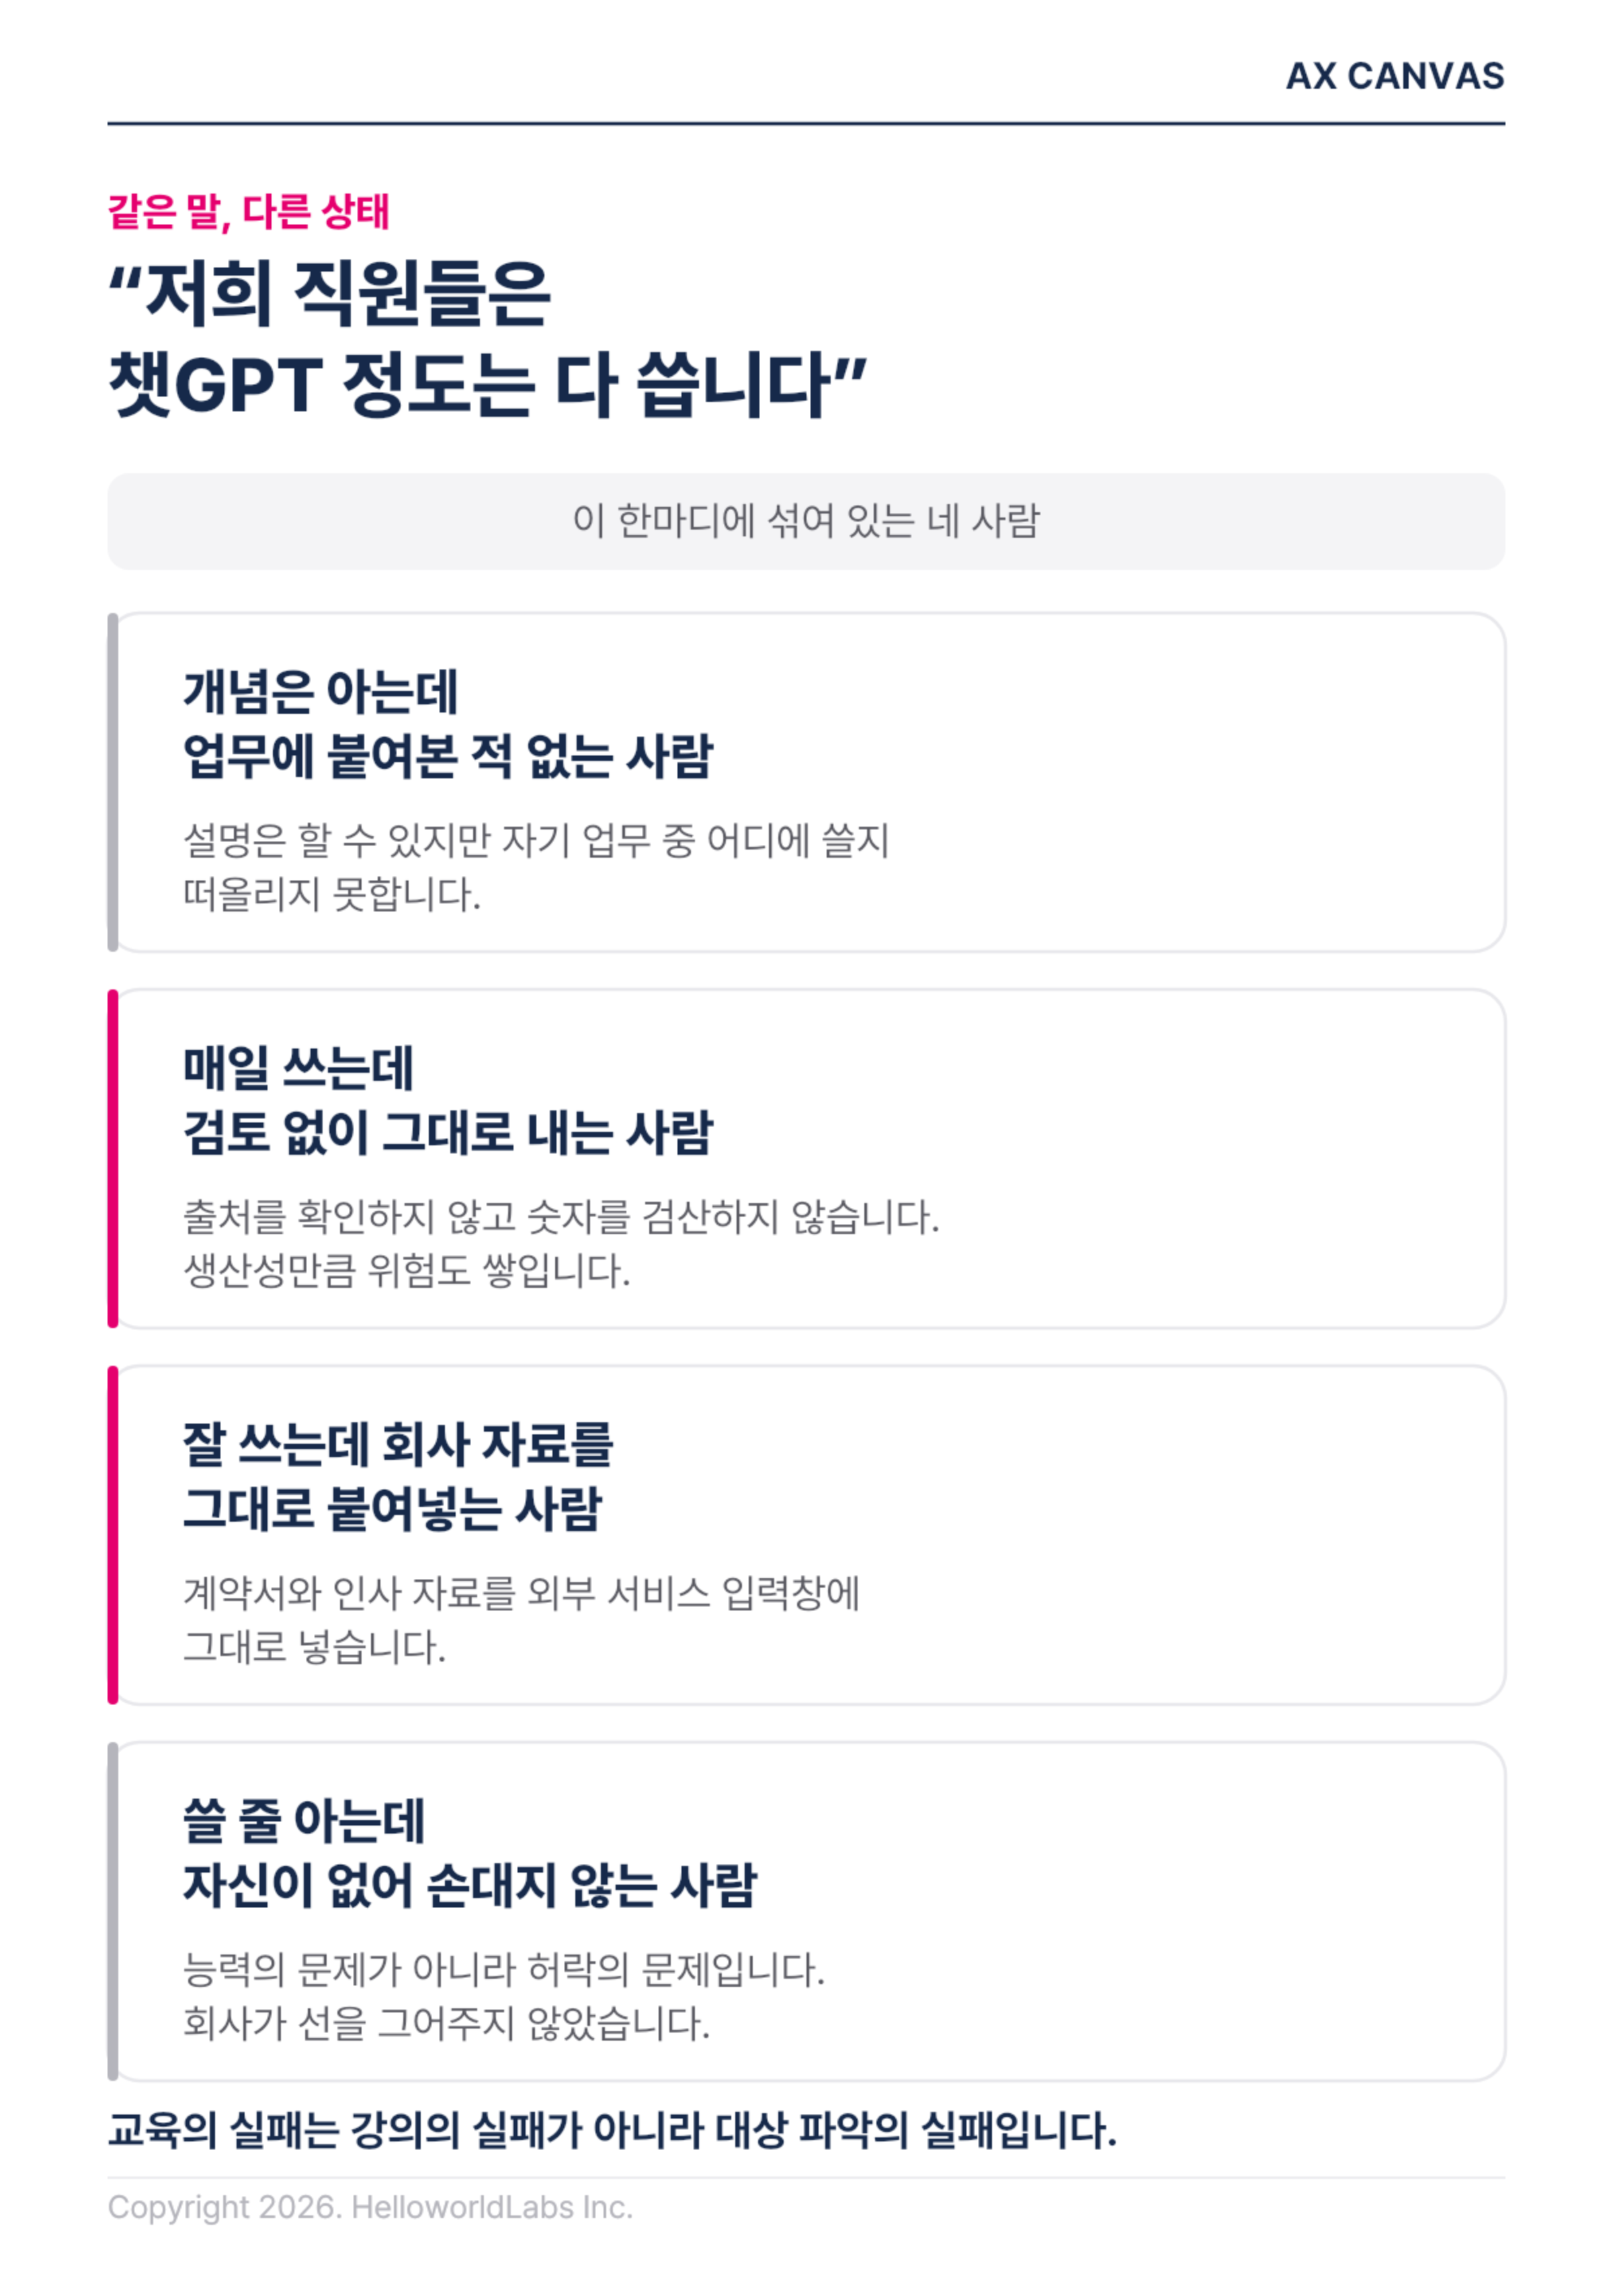
개념은 아는데 업무에 붙여본 적은 없는 사람.
AI가 무엇인지 설명은 할 수 있습니다. 하지만 자기 업무 중 어디에 쓸지는 떠올리지 못합니다. 써보라고 하면 "제 일은 좀 달라서요"라고 답합니다.매일 쓰는데 검토 없이 그대로 내는 사람.
생산성은 확실히 높습니다. 문제는 AI가 틀렸을 때입니다. 출처를 확인하지 않고, 숫자를 검산하지 않고, 어색한 문장을 그대로 보고서에 넣습니다.잘 쓰는데 회사 자료를 그대로 붙여넣는 사람.
결과물의 질은 좋습니다. 그런데 고객사 계약서를, 인사 자료를, 아직 공개되지 않은 실적을 외부 서비스 입력창에 붙여넣습니다.쓸 줄 아는데 자신이 없어 손대지 않는 사람.
교육을 받았고 방법도 압니다. 다만 어디까지 써도 되는지 확신이 없어 멈춰 있습니다. 능력의 문제가 아니라 허락의 문제입니다.
이 네 사람을 한 강의실에 넣고 같은 내용을 같은 방식으로 설명하면 어떻게 될까요. 누군가에게는 너무 쉽고, 누군가에게는 너무 빠르고, 누군가에게는 정작 필요한 이야기가 빠집니다. 만족도는 그럭저럭 나옵니다. 그리고 업무는 그대로입니다.
교육의 실패는 대개 강의의 실패가 아니라 대상 파악의 실패입니다.
그런데 '평균 68점'으로는 이 넷을 구분할 수 없습니다
여기서 진단의 조건이 나옵니다.
종합 점수 하나와 등급 한 줄로 끝나는 진단은 위의 네 사람을 갈라내지 못합니다. '우리 회사 평균 68점, B등급'이라는 결과를 받아 들고 무엇을 먼저 가르칠지 결정할 수 있는 담당자는 없습니다.
경로 설계의 입력값이 되려면 진단은 최소한 두 가지를 해야 합니다. 역량을 쪼개서 보는 것, 그리고 자기평가를 그대로 믿지 않는 것입니다.
조건 하나 · 역량을 쪼개서 봅니다
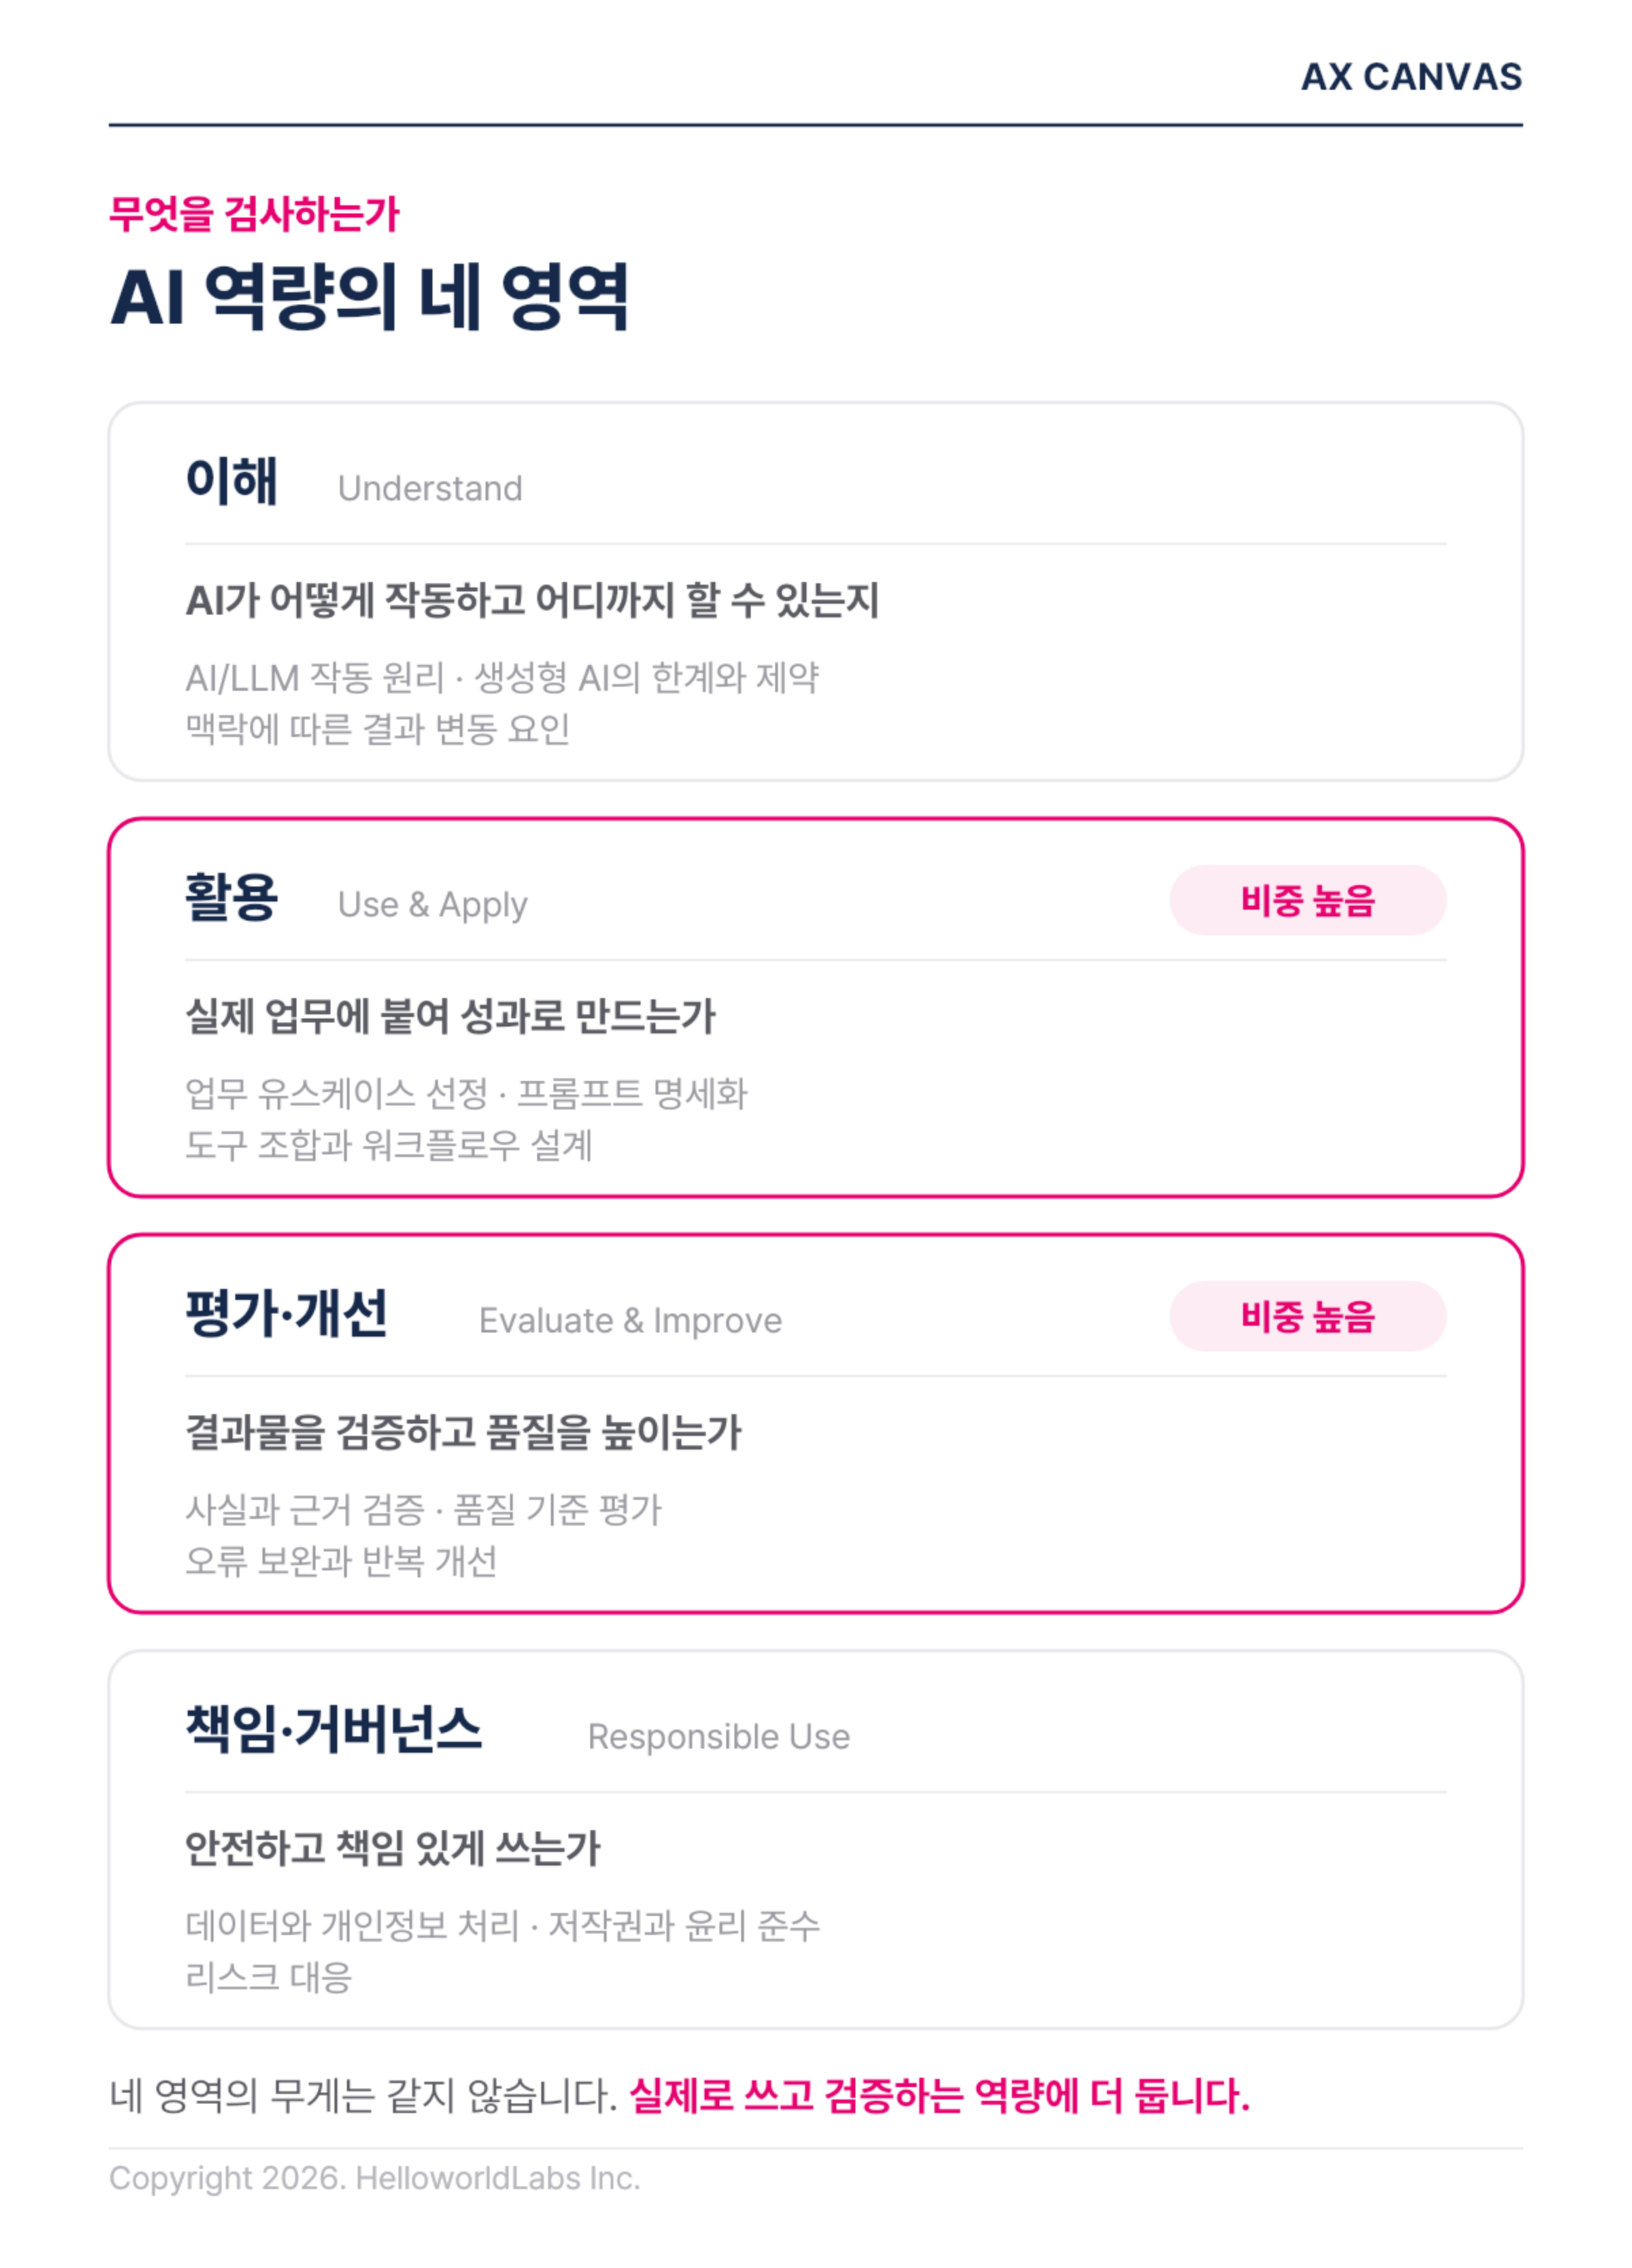
AX Compass는 AI 역량을 하나로 뭉뚱그리지 않습니다. 실무에서 AI를 쓸 때 필요한 능력을 네 개 영역으로 나눠 각각 진단합니다.
역량 | 무엇을 보는가 | 하위 역량 |
|---|---|---|
이해 | AI가 어떻게 작동하고 어디까지 할 수 있는지 | AI/LLM 작동 원리 · 생성형 AI의 한계와 제약 · 맥락에 따른 결과 변동 요인 |
활용 | 실제 업무에 붙여 성과로 만드는가 | 업무 유스케이스 선정 · 프롬프트 명세화 · 도구 조합과 워크플로우 설계 |
평가·개선 | 결과물을 검증하고 품질을 높이는가 | 사실과 근거 검증 · 품질 기준 평가 · 오류 보완과 반복 개선 |
책임·거버넌스 | 안전하고 책임 있게 쓰는가 | 데이터와 개인정보 처리 · 저작권과 윤리 준수 · 리스크 대응 |
앞의 네 사람을 이 표에 얹어보면 위치가 분명해집니다.
개념만 아는 사람 → 이해는 있고 활용이 비었습니다
검토 없이 내는 사람 → 활용은 높고 평가·개선이 비었습니다
회사 자료를 붙여넣는 사람 → 활용은 높고 책임·거버넌스가 비었습니다
손대지 않는 사람 → 역량은 있는데 활용이 비었습니다. 원인은 능력이 아니라 기준입니다
같은 '68점'이어도 어느 칸이 비었는지에 따라 필요한 교육이 완전히 달라집니다.
네 영역의 무게는 같지 않습니다
종합 점수를 낼 때 네 역량이 똑같은 비중으로 들어가지는 않습니다. 실제로 써서 성과를 만드는 역량(활용)과 결과를 검증하는 역량(평가·개선)에 더 큰 무게를 둡니다.
아는 것보다 하는 것이 중요하다는 판단이 채점 방식에 그대로 반영돼 있습니다.
조건 둘 · 자기평가를 그대로 믿지 않습니다
역량 진단에서 가장 흔한 실패는 스스로 매긴 점수를 그대로 받아 적는 것입니다.
"나는 AI를 업무에 잘 활용한다"에 5점을 준 사람이 실제로 잘 활용한다는 보장은 없습니다. 자신을 과대평가하는 사람도 있고, 반대로 충분히 잘하면서 낮게 매기는 사람도 있습니다. 설문을 한 번 돌려본 담당자라면 이미 겪어보셨을 겁니다.
그래서 AX Compass는 같은 역량을 세 가지 방식으로 나눠 묻습니다.
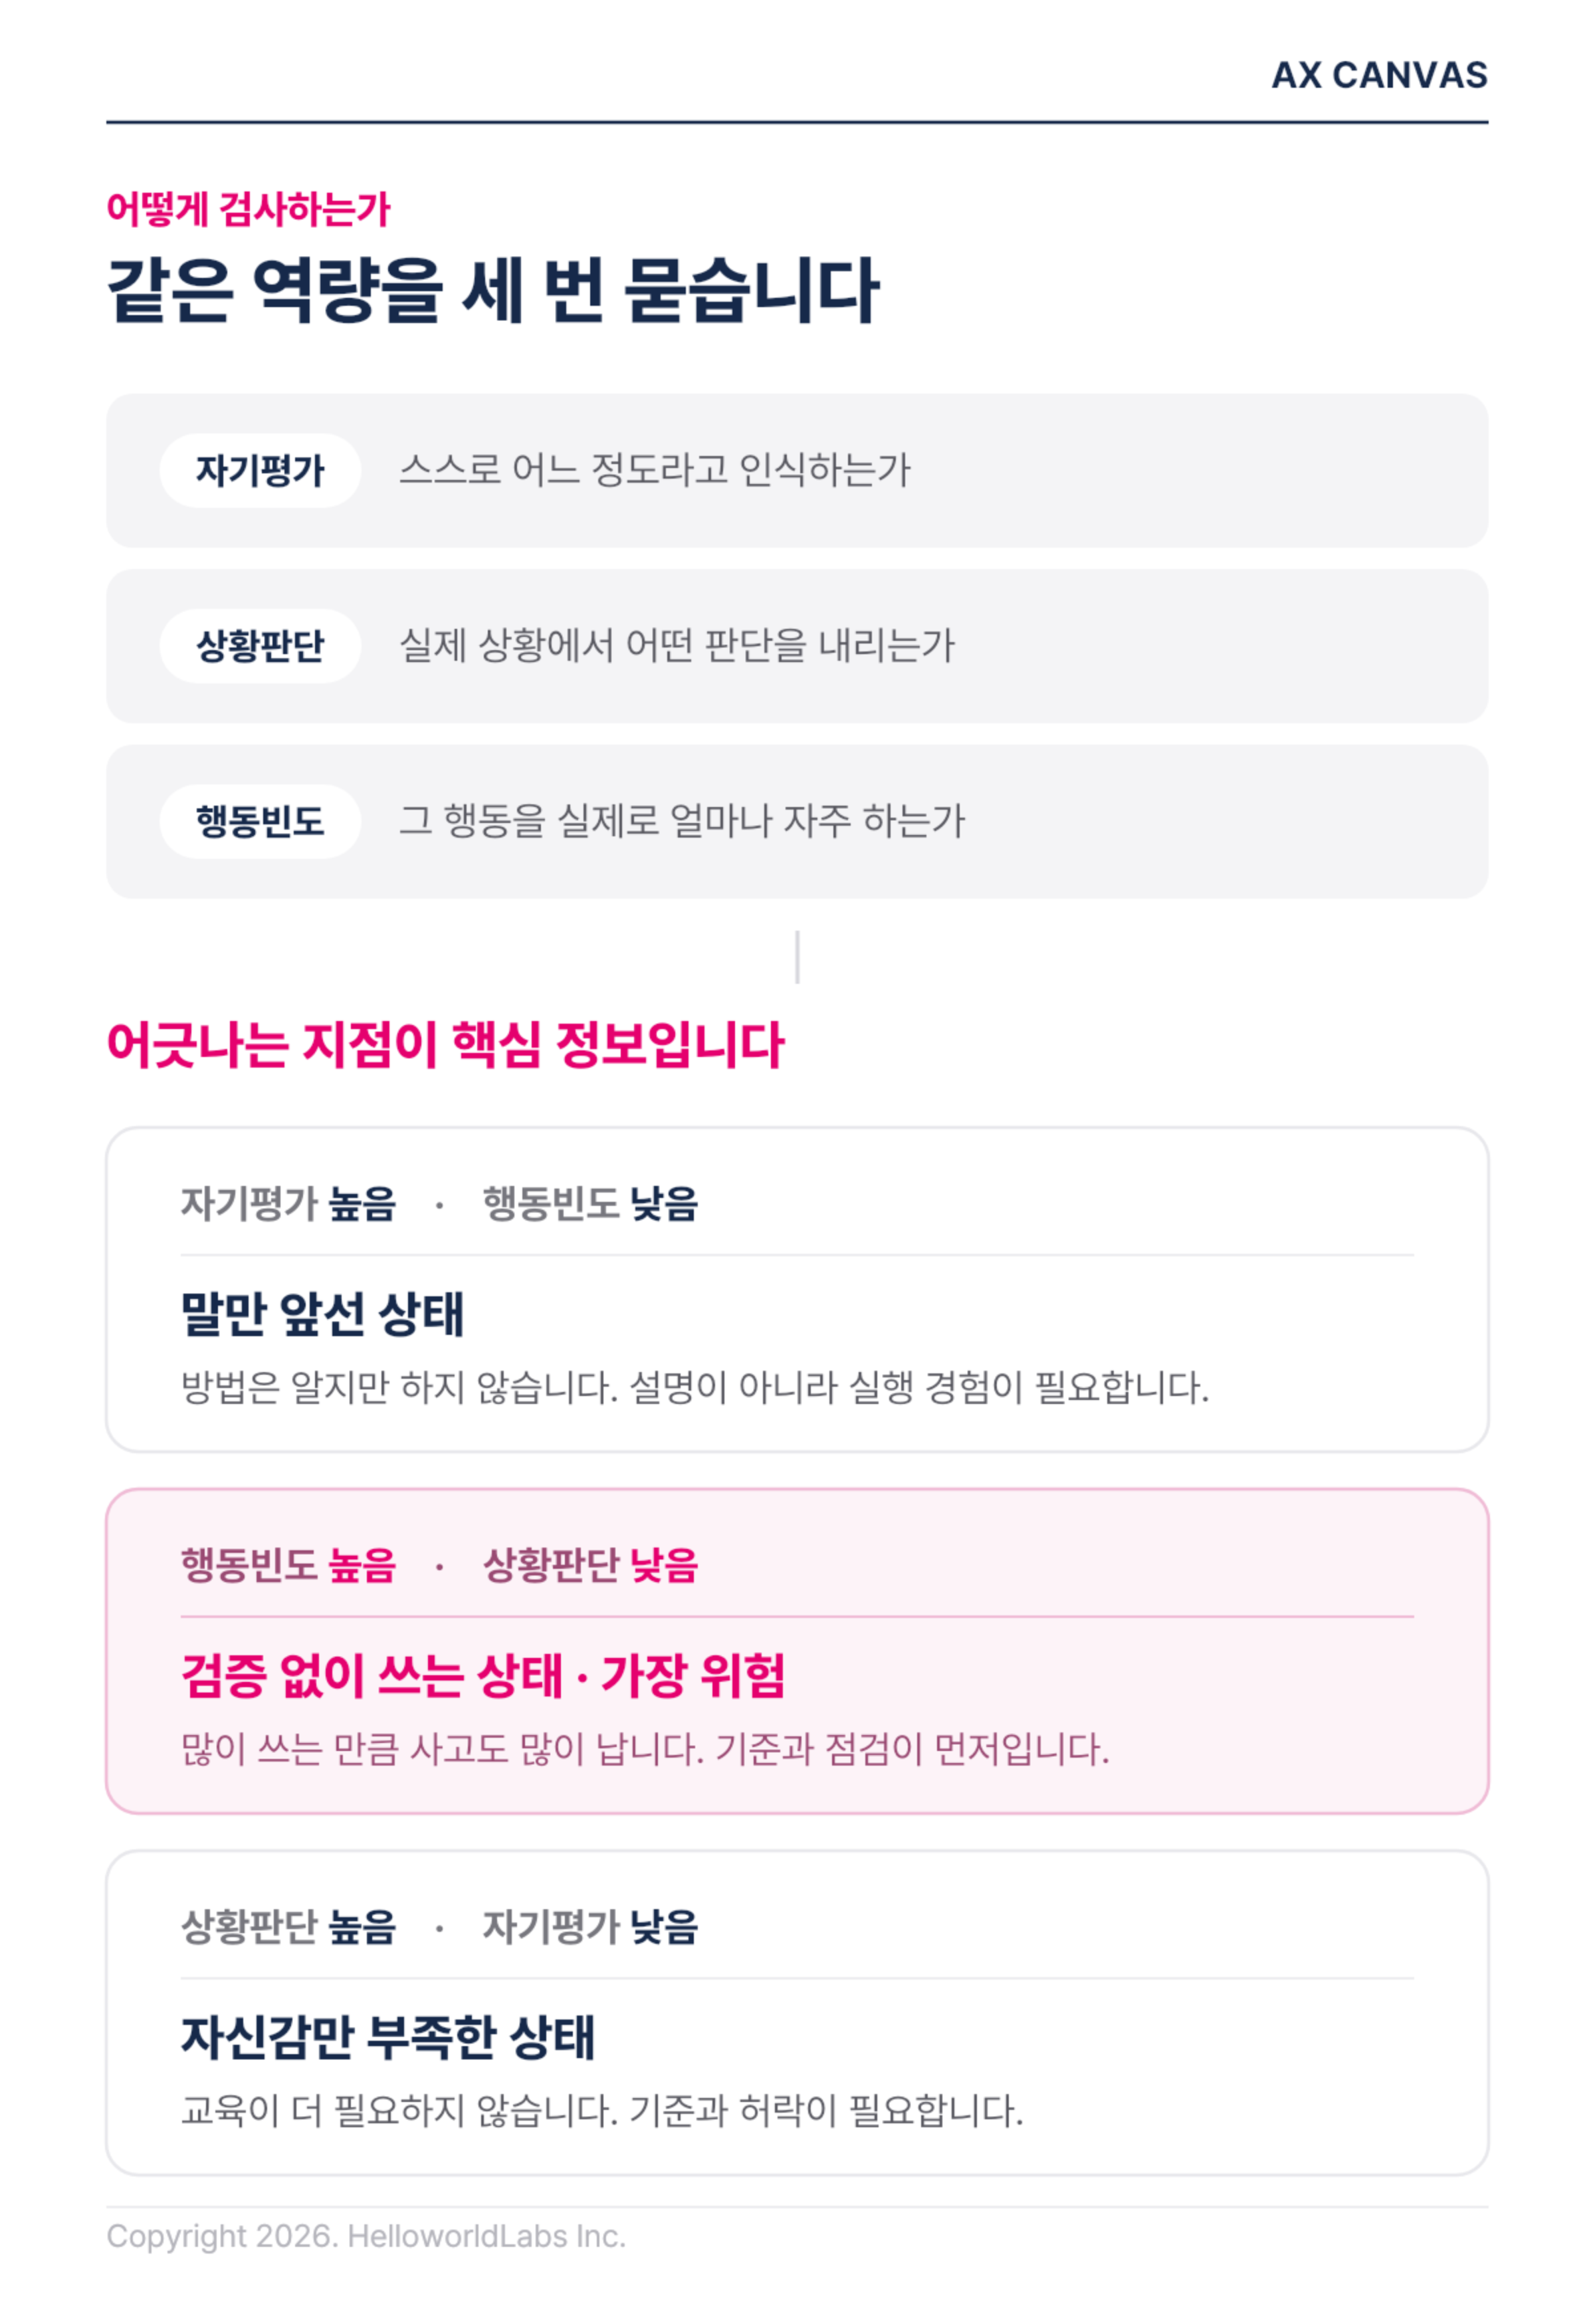
자기평가 문항 — 지금 스스로 어느 정도라고 인식하는가
상황판단 문항 — 실제 업무 상황이 주어졌을 때 어떤 판단을 내리는가
행동빈도 문항 — 그 행동을 실제로 얼마나 자주 하는가
인식, 판단, 행동. 이 셋은 사람마다 어긋납니다. 그리고 어긋나는 지점이 진단의 핵심 정보입니다.
어긋남이 말해주는 것
자기평가는 높은데 행동빈도가 낮다
→ 말만 앞선 상태입니다. 방법은 알지만 실제로 하지는 않습니다. 이 사람에게 필요한 것은 설명이 아니라 실행 경험입니다.행동빈도는 높은데 상황판단이 낮다
→ 검증 없이 쓰는 상태입니다. 가장 위험한 조합입니다. 많이 쓰는 만큼 사고도 많이 납니다. 앞서 나온 '검토 없이 내는 사람'과 '회사 자료를 붙여넣는 사람'이 여기 있습니다.상황판단은 정확한데 자기평가가 낮다
→ 자신감만 부족한 상태입니다. 교육을 더 받을 필요가 없습니다. 이 사람에게 필요한 것은 기준과 허락입니다.
점수 한 줄로는 이 셋을 절대 구분할 수 없습니다. 인식·판단·행동을 함께 봐야 비로소 보입니다.
여기까지가 '무엇을 검사하는가'입니다
정리하면 이렇습니다.
역량검사가 ② 현재 진단의 자리를 채우려면 네 영역으로 쪼개서, 인식·판단·행동을 함께 봐야 합니다. 그래야 '평균 68점'이 아니라 "우리 조직은 쓰긴 잘 쓰는데 검증을 안 한다"는 문장이 나옵니다. 그리고 그 문장이 있어야 교육을 설계할 수 있습니다.
다음 편에서는
그런데 여기서 한 걸음 더 들어가야 합니다.
같은 70점을 받은 두 사람이 있다고 해봅시다. 네 역량의 점수도 비슷합니다. 그렇다면 두 사람에게 같은 교육을 해도 될까요.
그렇지 않습니다.
4부에서는 점수가 말해주지 않는 것, 그러니까 사람마다 다른 AI 활용 성향을 어떻게 읽어내고, 그 결과가 실제 교육 운영을 어떻게 바꾸는지 이야기하겠습니다.
📚 AX, 어디부터 시작할 것인가 (전 6부)
1부. AI를 도입했는데, 왜 일하는 방식은 그대로일까
2부. AX에는 프레임워크가 필요하다 — AX CANVAS 6단계
3부. 역량검사 ① 'AI 좀 씁니다'로는 알 수 없는 것 ← 지금 읽고 있는 글
4부. 역량검사 ② 같은 70점도 서로 다른 70점이다
5부. "그래서 효과가 있었습니까"에 답하는 법
6부. AX는 한 번으로 끝나지 않는다
㈜헬로월드랩스 조직의 AI 역량 진단부터 교육 설계, 성과 검증까지 하나의 흐름으로 연결합니다.
문의 | ax@helloworldlabs.kr · 070-8833-7771


